İçeriğe geç

Blog arşivi

540 yazıdan 529–540 arası gösteriliyor, en yeniden eskiye.

Karşılaştırma

Single-Agent mı Multi-Agent mı? Hangi Problemde Hangi Agent Mimarisini Seçmelisiniz?

AI agent sistemleri yaygınlaştıkça, ekiplerin karşısına çıkan en kritik mimari sorulardan biri şu oluyor: Tek bir güçlü agent mı kullanılmalı, yoksa görevler birden fazla uzman agent arasında mı dağıtılmalı? Birçok ekip multi-agent yapıları daha gelişmiş ve daha güçlü sanarak gereksiz karmaşıklık kurarken, bazıları da gerçekten ayrışmış görevleri tek bir agent içine sıkıştırarak kalite, kontrol ve ölçeklenebilirlik sorunları yaşıyor. Bu kapsamlı rehberde, single-agent ve multi-agent mimarileri teknik, operasyonel, maliyet, güvenlik, observability, coordination ve governance boyutlarıyla karşılaştırıyor; hangi problem tipinde hangi mimarinin daha doğru olduğunu ve kurumsal ortamlarda kararın nasıl verilmesi gerektiğini detaylı biçimde ele alıyoruz.
25 dkAjanlar
Rehber

Tool Calling, Planning ve Memory: Güvenilir AI Agent Mimarisi Nasıl Kurulur?

Güvenilir bir AI agent sistemi kurmak, yalnızca büyük dil modeline araç erişimi vermekten ibaret değildir. Gerçek üretim kalitesi; agent’ın hangi aracı ne zaman çağıracağını, çok adımlı görevlerde nasıl plan yapacağını, hangi bilgiyi ne kadar süreyle hatırlayacağını, ne zaman insana duracağını ve tüm bu akışın nasıl gözlemlenip denetleneceğini tasarlamayı gerektirir. Bu kapsamlı rehberde, tool calling, planning ve memory katmanlarını kurumsal mimari perspektifiyle ele alıyor; güvenilir agent sistemleri için state management, human-in-the-loop, observability, güvenlik ve governance boyutlarıyla birlikte uçtan uca bir tasarım çerçevesi sunuyoruz.

25 dkAjanlar
Derinlemesine

RAG Projeleri Neden Başarısız Olur? Veri Hazırlığı, Evaluation ve Prompt Katmanındaki Kritik Hatalar

RAG projeleri çoğu zaman ilk demoda etkileyici görünür; ancak üretim ortamında kalite, güven ve sürdürülebilirlik sorunları yaşamaya başlar. Bunun temel nedeni genellikle modelin zayıflığı değil, veri hazırlığı, retrieval mimarisi, evaluation eksikliği ve prompt katmanındaki yapısal hatalardır. Kirli ve güncel olmayan dokümanlar, düşünülmemiş chunking, yetersiz metadata, retrieval kalitesini ölçmeyen test yapıları ve modele yanlış davranış kuralları veren prompt’lar; en güçlü LLM’leri bile düşük güvenli cevaplar üretmeye iter. Bu kapsamlı rehberde, RAG projelerinin neden başarısız olduğunu; veri hazırlığı, evaluation ve prompt tasarımı ekseninde kök nedenleriyle inceliyor, üretim seviyesinde daha dayanıklı RAG sistemleri kurmak için uygulanabilir bir çerçeve sunuyoruz.

24 dkRAG
Rehber

Hybrid Search, Metadata Filtering ve Query Rewriting ile RAG Kalitesi Nasıl Artırılır?

RAG sistemlerinde kalite problemi çoğu zaman modelden değil, retrieval katmanından kaynaklanır. Yanlış chunk’ların seçilmesi, güncel olmayan dokümanların öne çıkması, exact-match gerektiren sorguların kaçırılması veya kullanıcı niyetinin retrieval’a doğru çevrilememesi; en güçlü büyük dil modellerini bile hatalı ve düşük güvenli cevaplar üretmeye iter. Bu kapsamlı rehberde, RAG kalitesini artırmak için en kritik üç tasarım yaklaşımını inceliyoruz: semantic ve lexical aramayı birleştiren hybrid search, kurumsal doğruluğu güçlendiren metadata filtering ve kullanıcı sorgusunu retrieval için daha etkili hale getiren query rewriting. Teknik mantığı, kurumsal senaryoları, sık yapılan hataları ve üretim seviyesinde uygulama stratejilerini detaylı biçimde ele alıyoruz.

22 dkRAG
Derinlemesine

Doküman Tabanlı AI Asistanı Geliştirme: PDF, Wiki, SOP ve Politika Verileriyle Güvenli RAG

Doküman tabanlı AI asistanları, kurumsal bilgiye doğal dil üzerinden hızlı, kaynaklı ve kontrollü erişim sağlamak için en güçlü yapay zekâ uygulamalarından biridir. Ancak üretim seviyesinde güvenli bir RAG sistemi kurmak; PDF, wiki, SOP ve politika dokümanlarını yalnızca indeksleyip modele bağlamaktan ibaret değildir. Belge toplama, parsing, sürüm yönetimi, erişim kontrolü, chunking, retrieval, kaynak doğruluğu, kullanıcı rolü, observability ve governance katmanları birlikte tasarlanmadığında sistem yanlış bilgi, eski sürüm içerik, güvenlik riski ve düşük kullanıcı güveni üretir. Bu kapsamlı rehberde, doküman tabanlı bir AI asistanının uçtan uca nasıl geliştirileceğini; veri kaynakları, güvenli RAG mimarisi, retrieval stratejileri, kalite ölçümü ve kurumsal devreye alma perspektifiyle detaylı biçimde inceliyoruz.

24 dkRAG
Karşılaştırma

RAG mi Fine-Tuning mi? Hangi Senaryoda Hangi Yaklaşım Daha Doğru?

Kurumsal yapay zekâ projelerinde en sık sorulan stratejik sorulardan biri şudur: Bir problemi çözmek için RAG mi kullanılmalı, yoksa fine-tuning mi yapılmalı? Pek çok ekip bu iki yaklaşımı birbirinin alternatifi gibi görse de gerçekte RAG ve fine-tuning farklı problem türlerini çözer. Biri güncel ve kaynaklı bilgi erişimini güçlendirirken, diğeri model davranışını ve görev uyumunu şekillendirir. Bu kapsamlı rehberde, RAG ve fine-tuning yaklaşımlarını teknik, operasyonel, maliyet, güvenlik, bakım ve üretim kalitesi açısından karşılaştırıyor; hangi senaryoda hangisinin doğru tercih olduğunu ve ne zaman hibrit mimari kurulması gerektiğini detaylı biçimde ele alıyoruz.

23 dkLLM
Rehber

Kurumsal RAG Sistemi Nasıl Tasarlanır? Chunking, Embedding, Retrieval ve Reranking Rehberi

Kurumsal RAG sistemleri, büyük dil modellerini şirket içi bilgiyle güvenilir, denetlenebilir ve kaynaklı biçimde buluşturmanın en güçlü yollarından biridir. Ancak üretim seviyesinde bir RAG mimarisi kurmak; sadece dokümanları vektör veritabanına yüklemekten ibaret değildir. Bilgi kaynağı seçimi, parsing, chunking stratejisi, embedding modeli, metadata kurgusu, hybrid retrieval, reranking, prompt assembly, evaluation, observability, güvenlik ve governance katmanları birlikte düşünülmediğinde sistem hızla kalite ve güven sorunları üretir. Bu kapsamlı rehberde, kurumsal RAG mimarisini uçtan uca ele alıyor; chunking, embedding, retrieval ve reranking başta olmak üzere, gerçekten üretimde çalışan ve kurum içinde güven kazanan RAG sistemlerinin nasıl tasarlanması gerektiğini detaylı biçimde inceliyoruz.

22 dkRAG
Karşılaştırma

AI Engineering Stack Karşılaştırması: Orkestrasyon, Deployment, Observability ve Evaluation Katmanları

Üretim seviyesinde yapay zekâ sistemleri kurmak, tek bir model veya tek bir araç seçmekten çok daha fazlasını gerektirir. Gerçek başarı; veri akışları, pipeline orkestrasyonu, model ve servis dağıtımı, gözlemlenebilirlik, kalite değerlendirmesi, güvenlik ve yönetişim katmanlarının uyumlu biçimde çalışmasına bağlıdır. Bu kapsamlı rehberde, AI engineering stack’in ana bileşenlerini; orkestrasyon, deployment, observability ve evaluation ekseninde karşılaştırmalı olarak inceliyor, hangi katmanın hangi problemi çözdüğünü, ekiplerin hangi hatalara düştüğünü ve kurumsal ölçekte daha doğru teknoloji kararlarının nasıl verileceğini detaylı biçimde ele alıyoruz.

21 dkLLMOps
Rehber

Model Monitoring, Drift ve Feedback Loop Tasarımı: Üretimde AI Sistemleri Nasıl Ayakta Kalır?

Bir yapay zekâ sistemini üretime almak, başarı yolculuğunun sonu değil; asıl operasyonel mücadelenin başlangıcıdır. Model izleme, veri drift’i, concept drift, segment bazlı kalite bozulmaları, geciken etiketler ve zayıf feedback loop tasarımı; zamanla en güçlü modelleri bile etkisiz hale getirebilir. Bu kapsamlı rehberde, üretimde AI sistemlerinin neden bozulduğunu, model monitoring katmanının nasıl kurulması gerektiğini, drift türlerini nasıl ayırt edeceğimizi ve sürdürülebilir feedback loop mimarisinin nasıl tasarlanacağını detaylı biçimde ele alıyoruz.

20 dkLLMOps
Derinlemesine

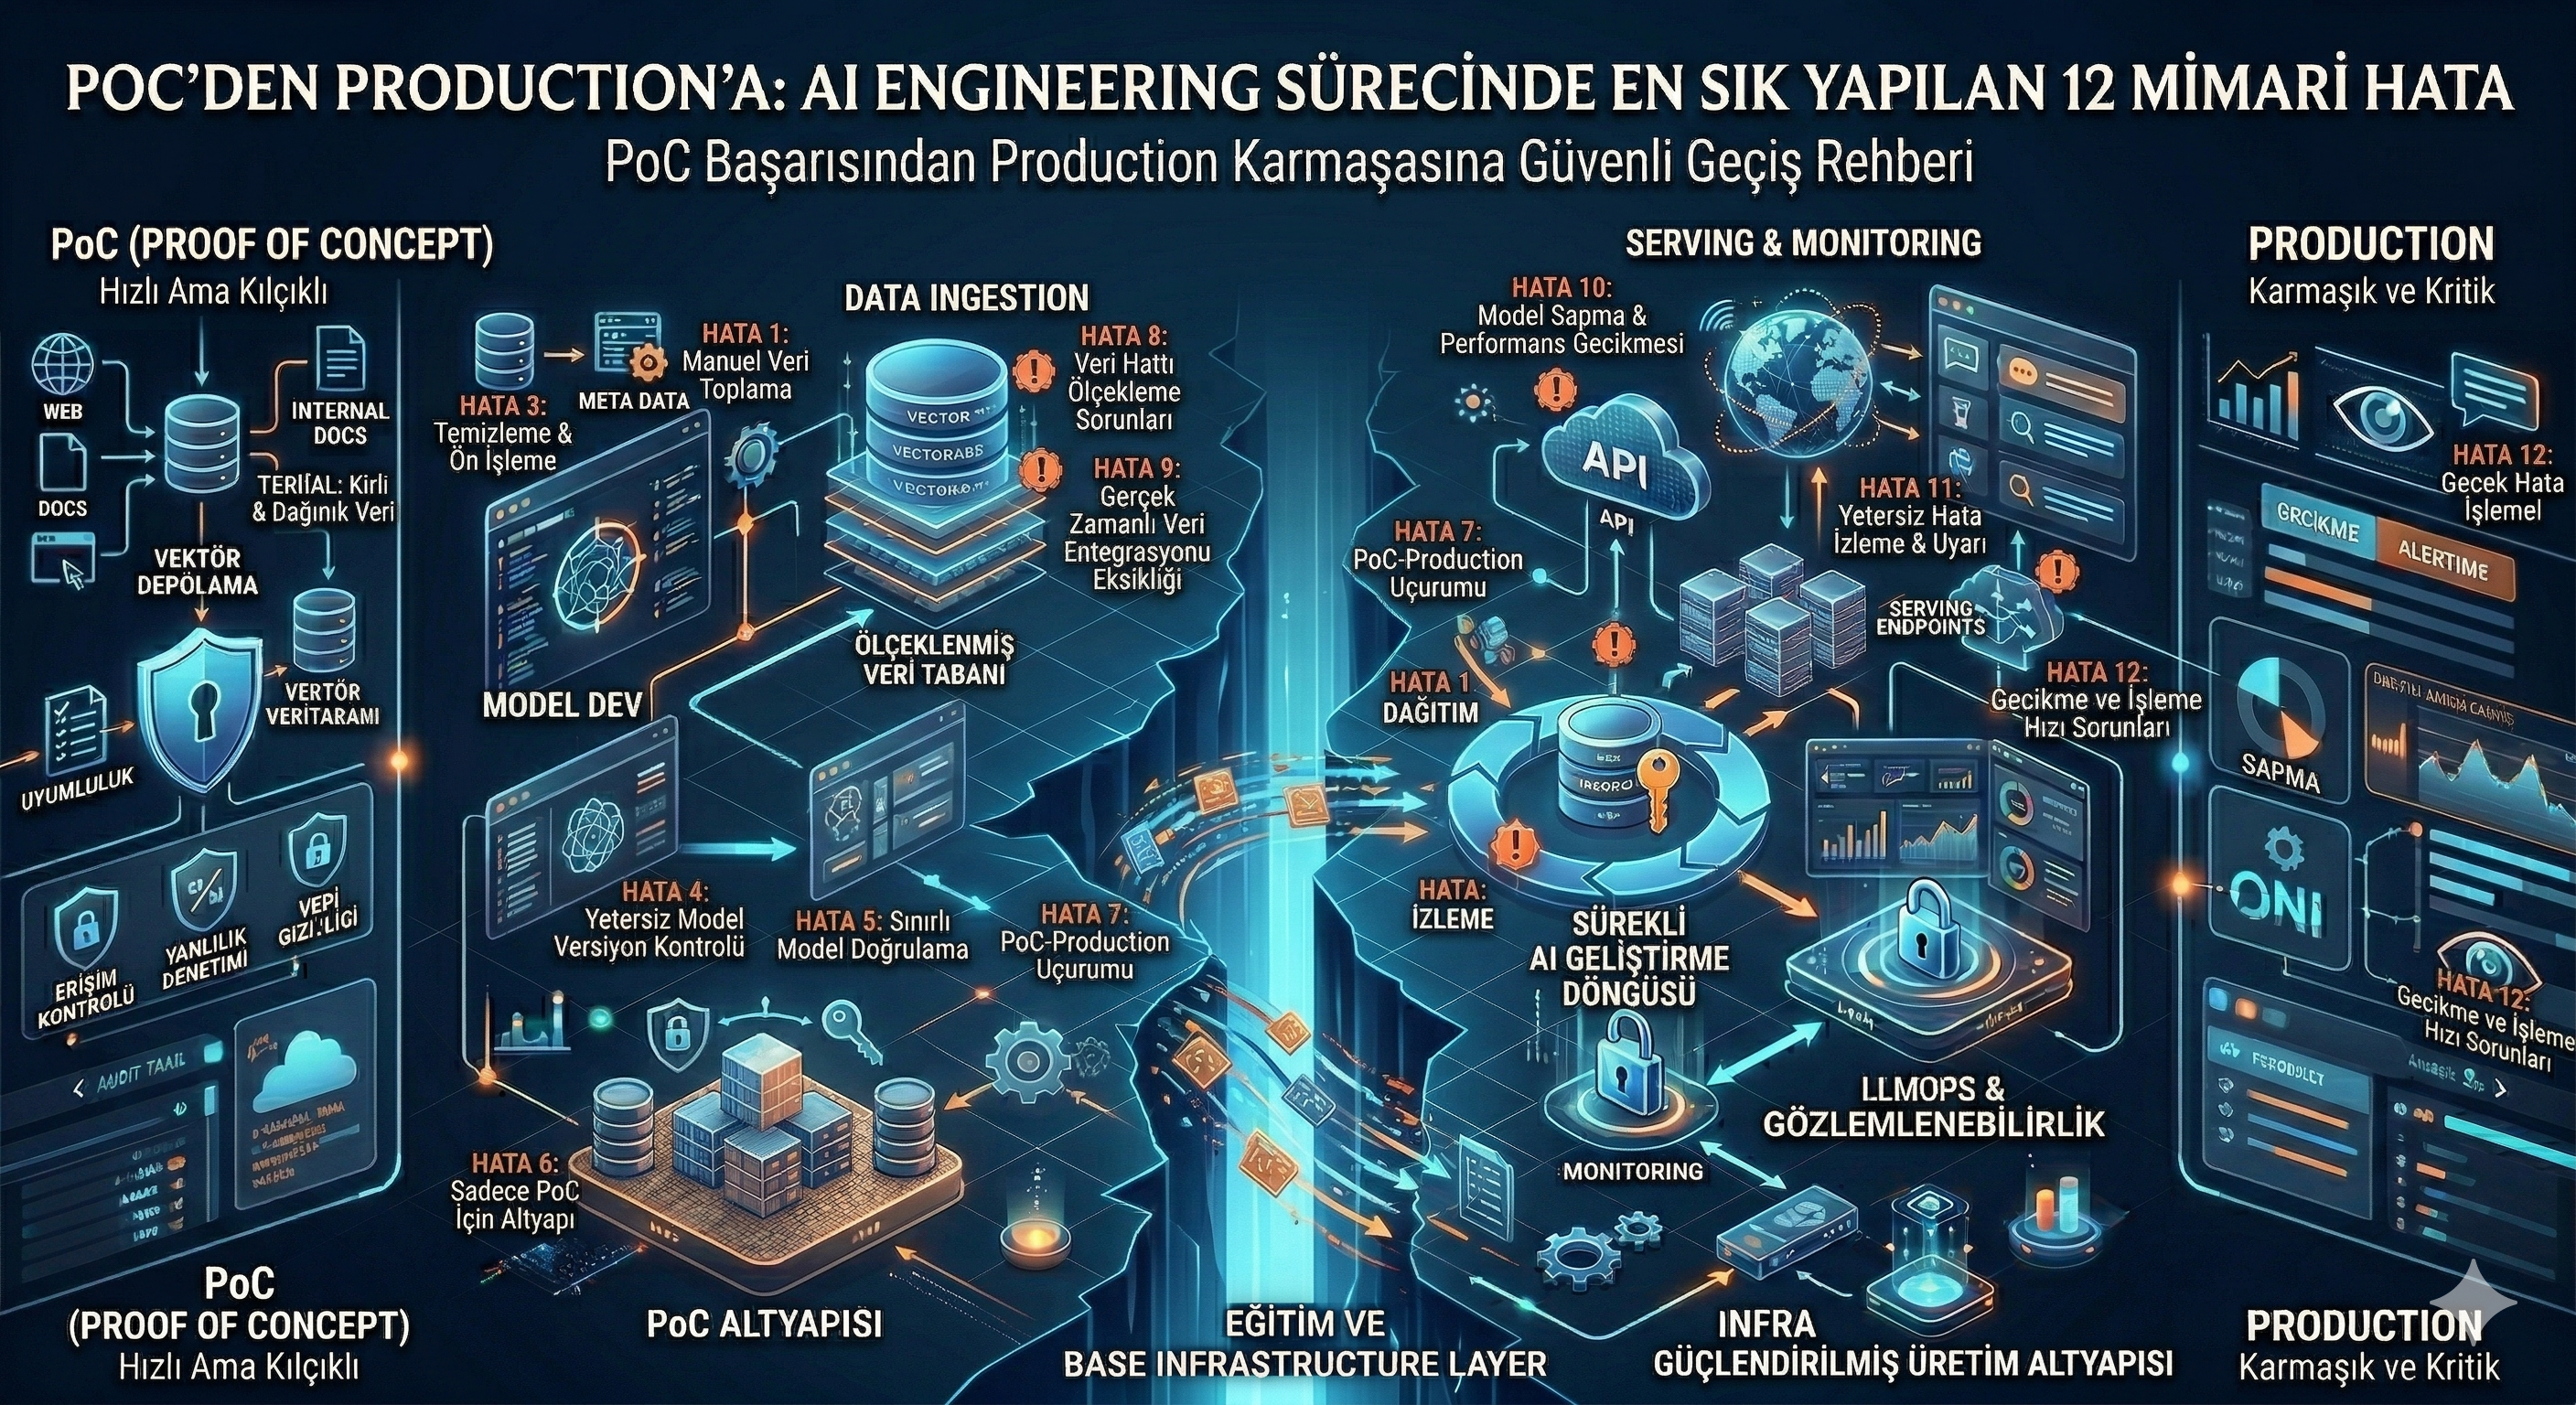
PoC’den Production’a: AI Engineering Sürecinde En Sık Yapılan 12 Mimari Hata

Yapay zekâ projelerinin önemli bir bölümü, güçlü bir PoC demosu ile başlasa da üretim ortamına geçişte kırılır. Bunun temel nedeni çoğu zaman model kalitesinin yetersiz olması değil; mimari kararların erken aşamada yanlış verilmesi, operasyonel gerçeklerin göz ardı edilmesi ve AI engineering disiplininin eksik uygulanmasıdır. Bu kapsamlı rehberde, PoC’den production’a geçiş sürecinde en sık yapılan 12 mimari hatayı; veri, model, servis, güvenlik, gözlemlenebilirlik, maliyet, governance ve ekip yapılanması perspektifleriyle detaylı şekilde inceliyoruz.

20 dkLLMOps
Rehber

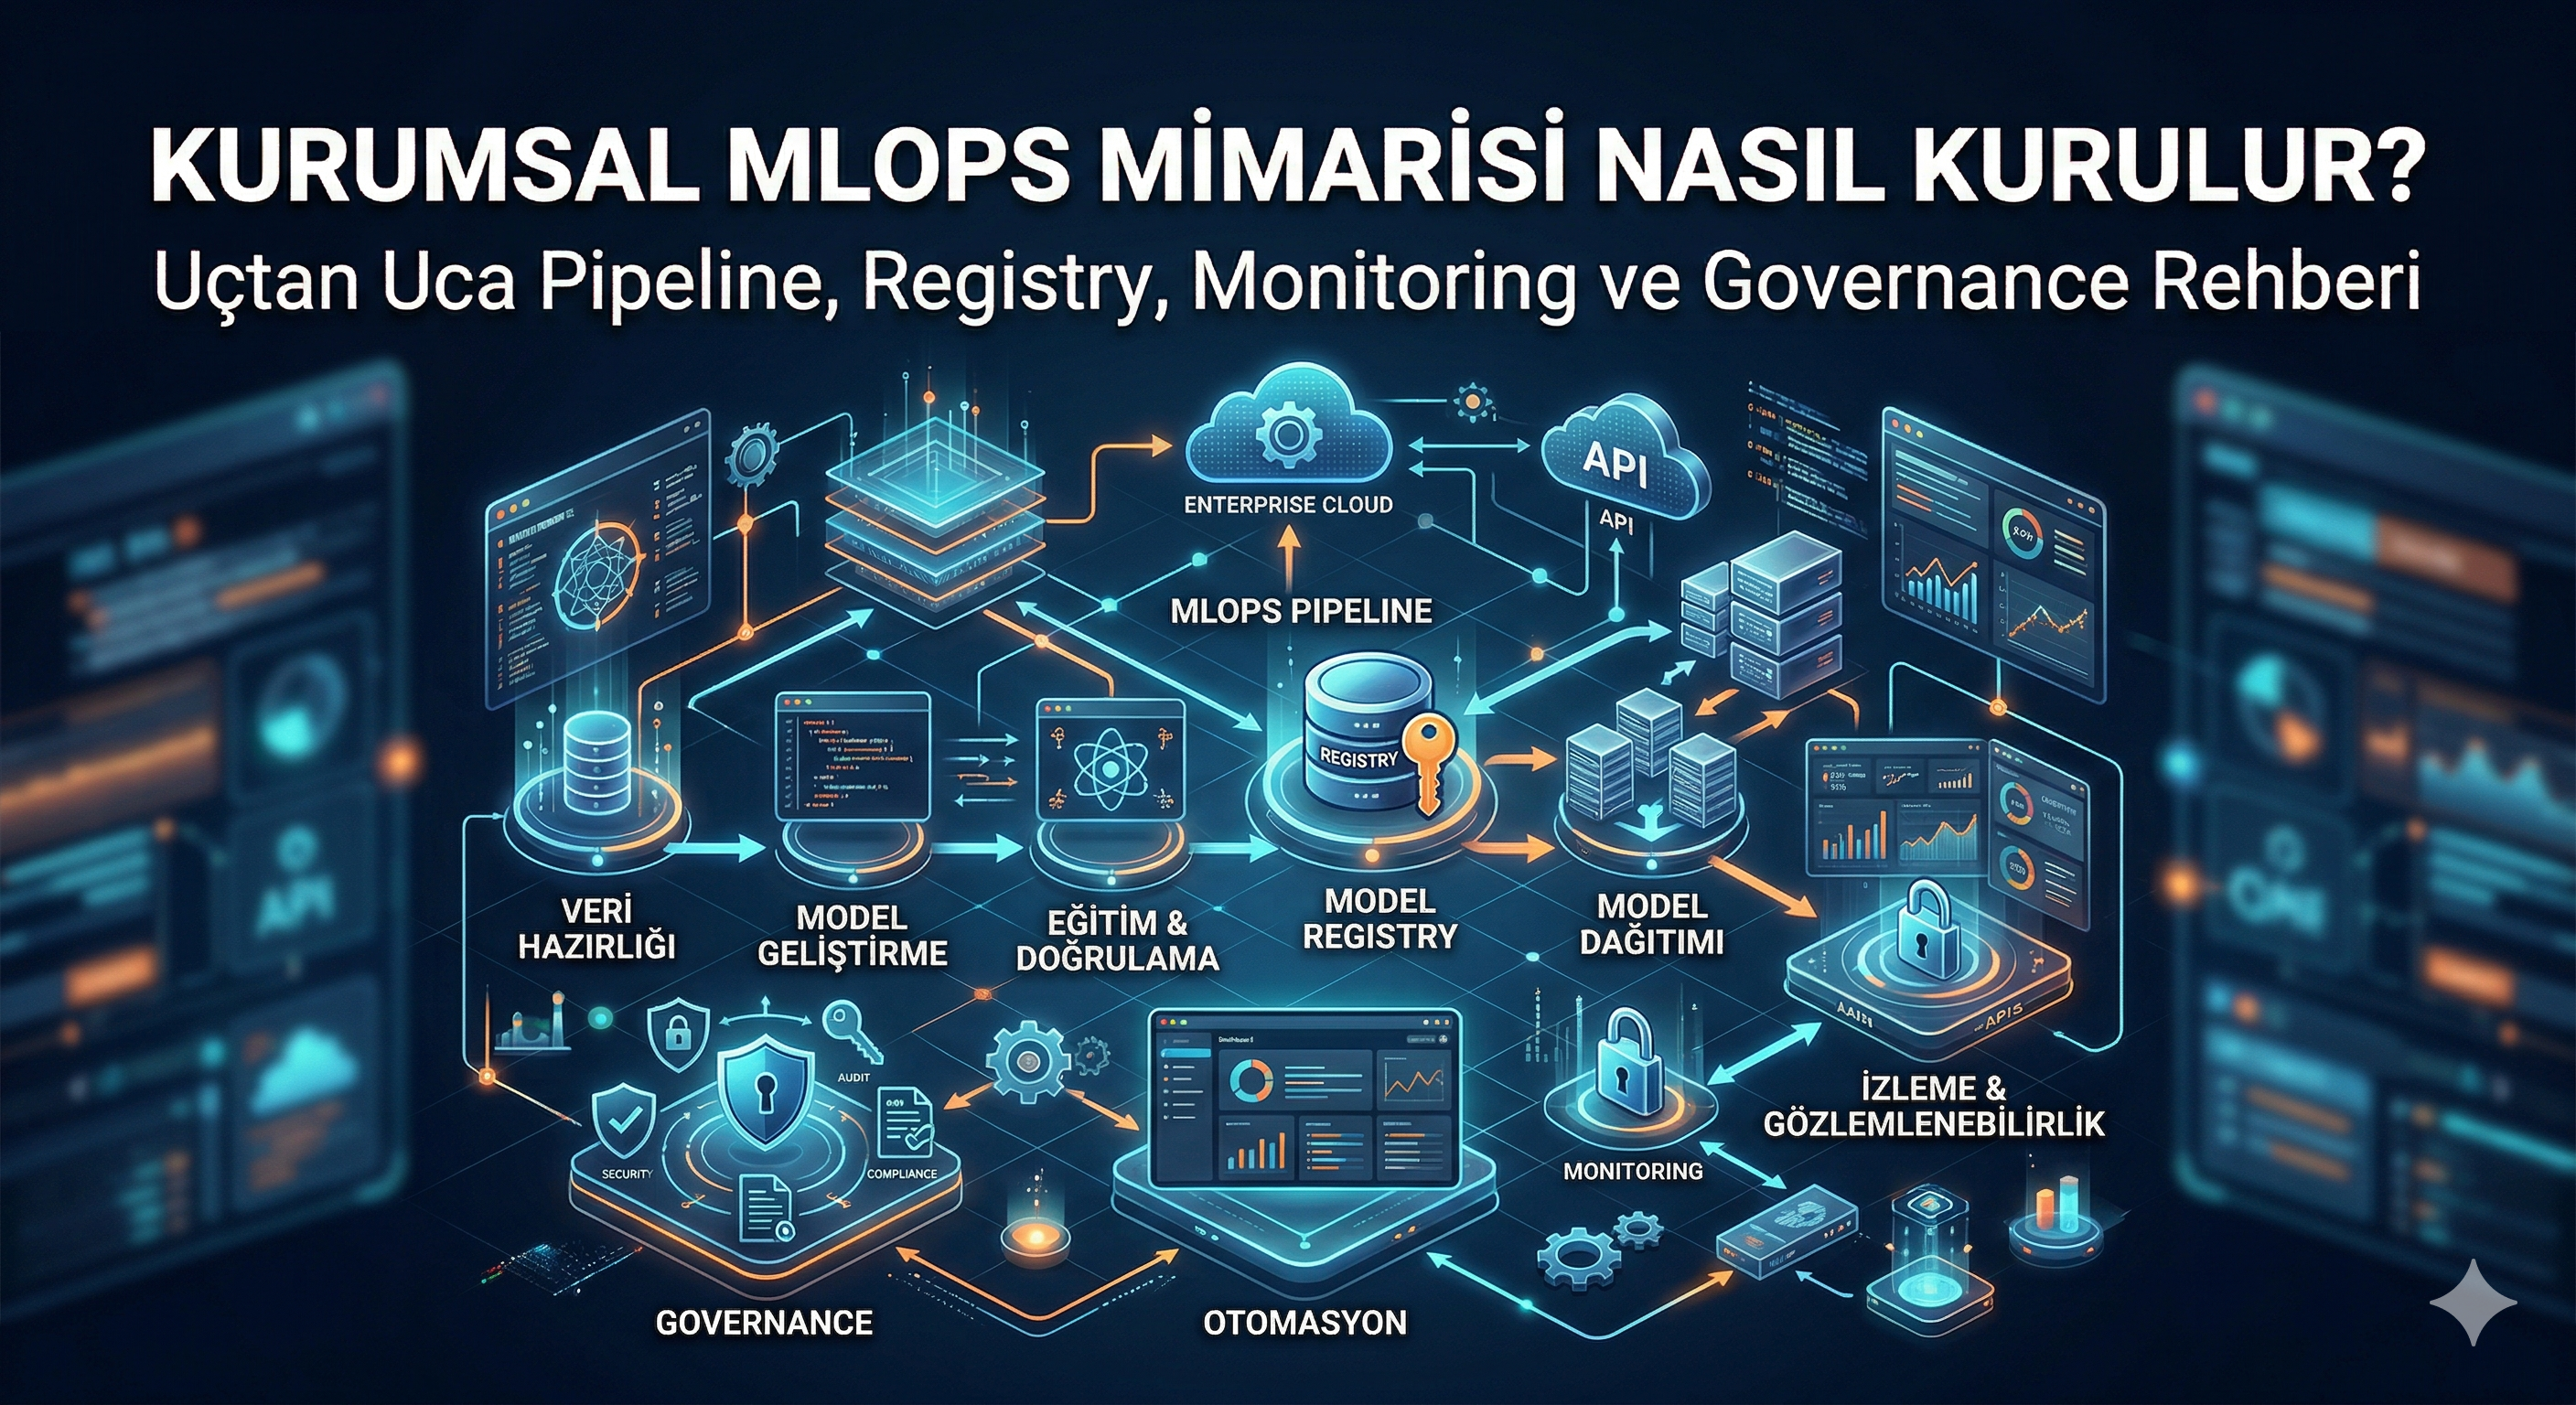
Kurumsal MLOps Mimarisi Nasıl Kurulur? Uçtan Uca Pipeline, Registry, Monitoring ve Governance Rehberi

Kurumsal ölçekte makine öğrenmesi sistemleri geliştirmek, yalnızca iyi bir model eğitmekten ibaret değildir. Gerçek değer; veri hazırlığından deney takibine, pipeline orkestrasyonundan model registry yapısına, dağıtımdan izleme ve yönetişime kadar uzanan uçtan uca bir MLOps mimarisi kurulduğunda ortaya çıkar. Bu rehberde, kurumsal MLOps’un temel katmanlarını, referans mimari yaklaşımını, operasyonel riskleri, izleme stratejilerini, governance çerçevesini ve 30-60-90 günlük uygulama planını detaylı biçimde ele alıyoruz.

18 dkLLMOps